LLM 로컬 구동 포맷 비교: GGUF vs MLX 완벽 가이드
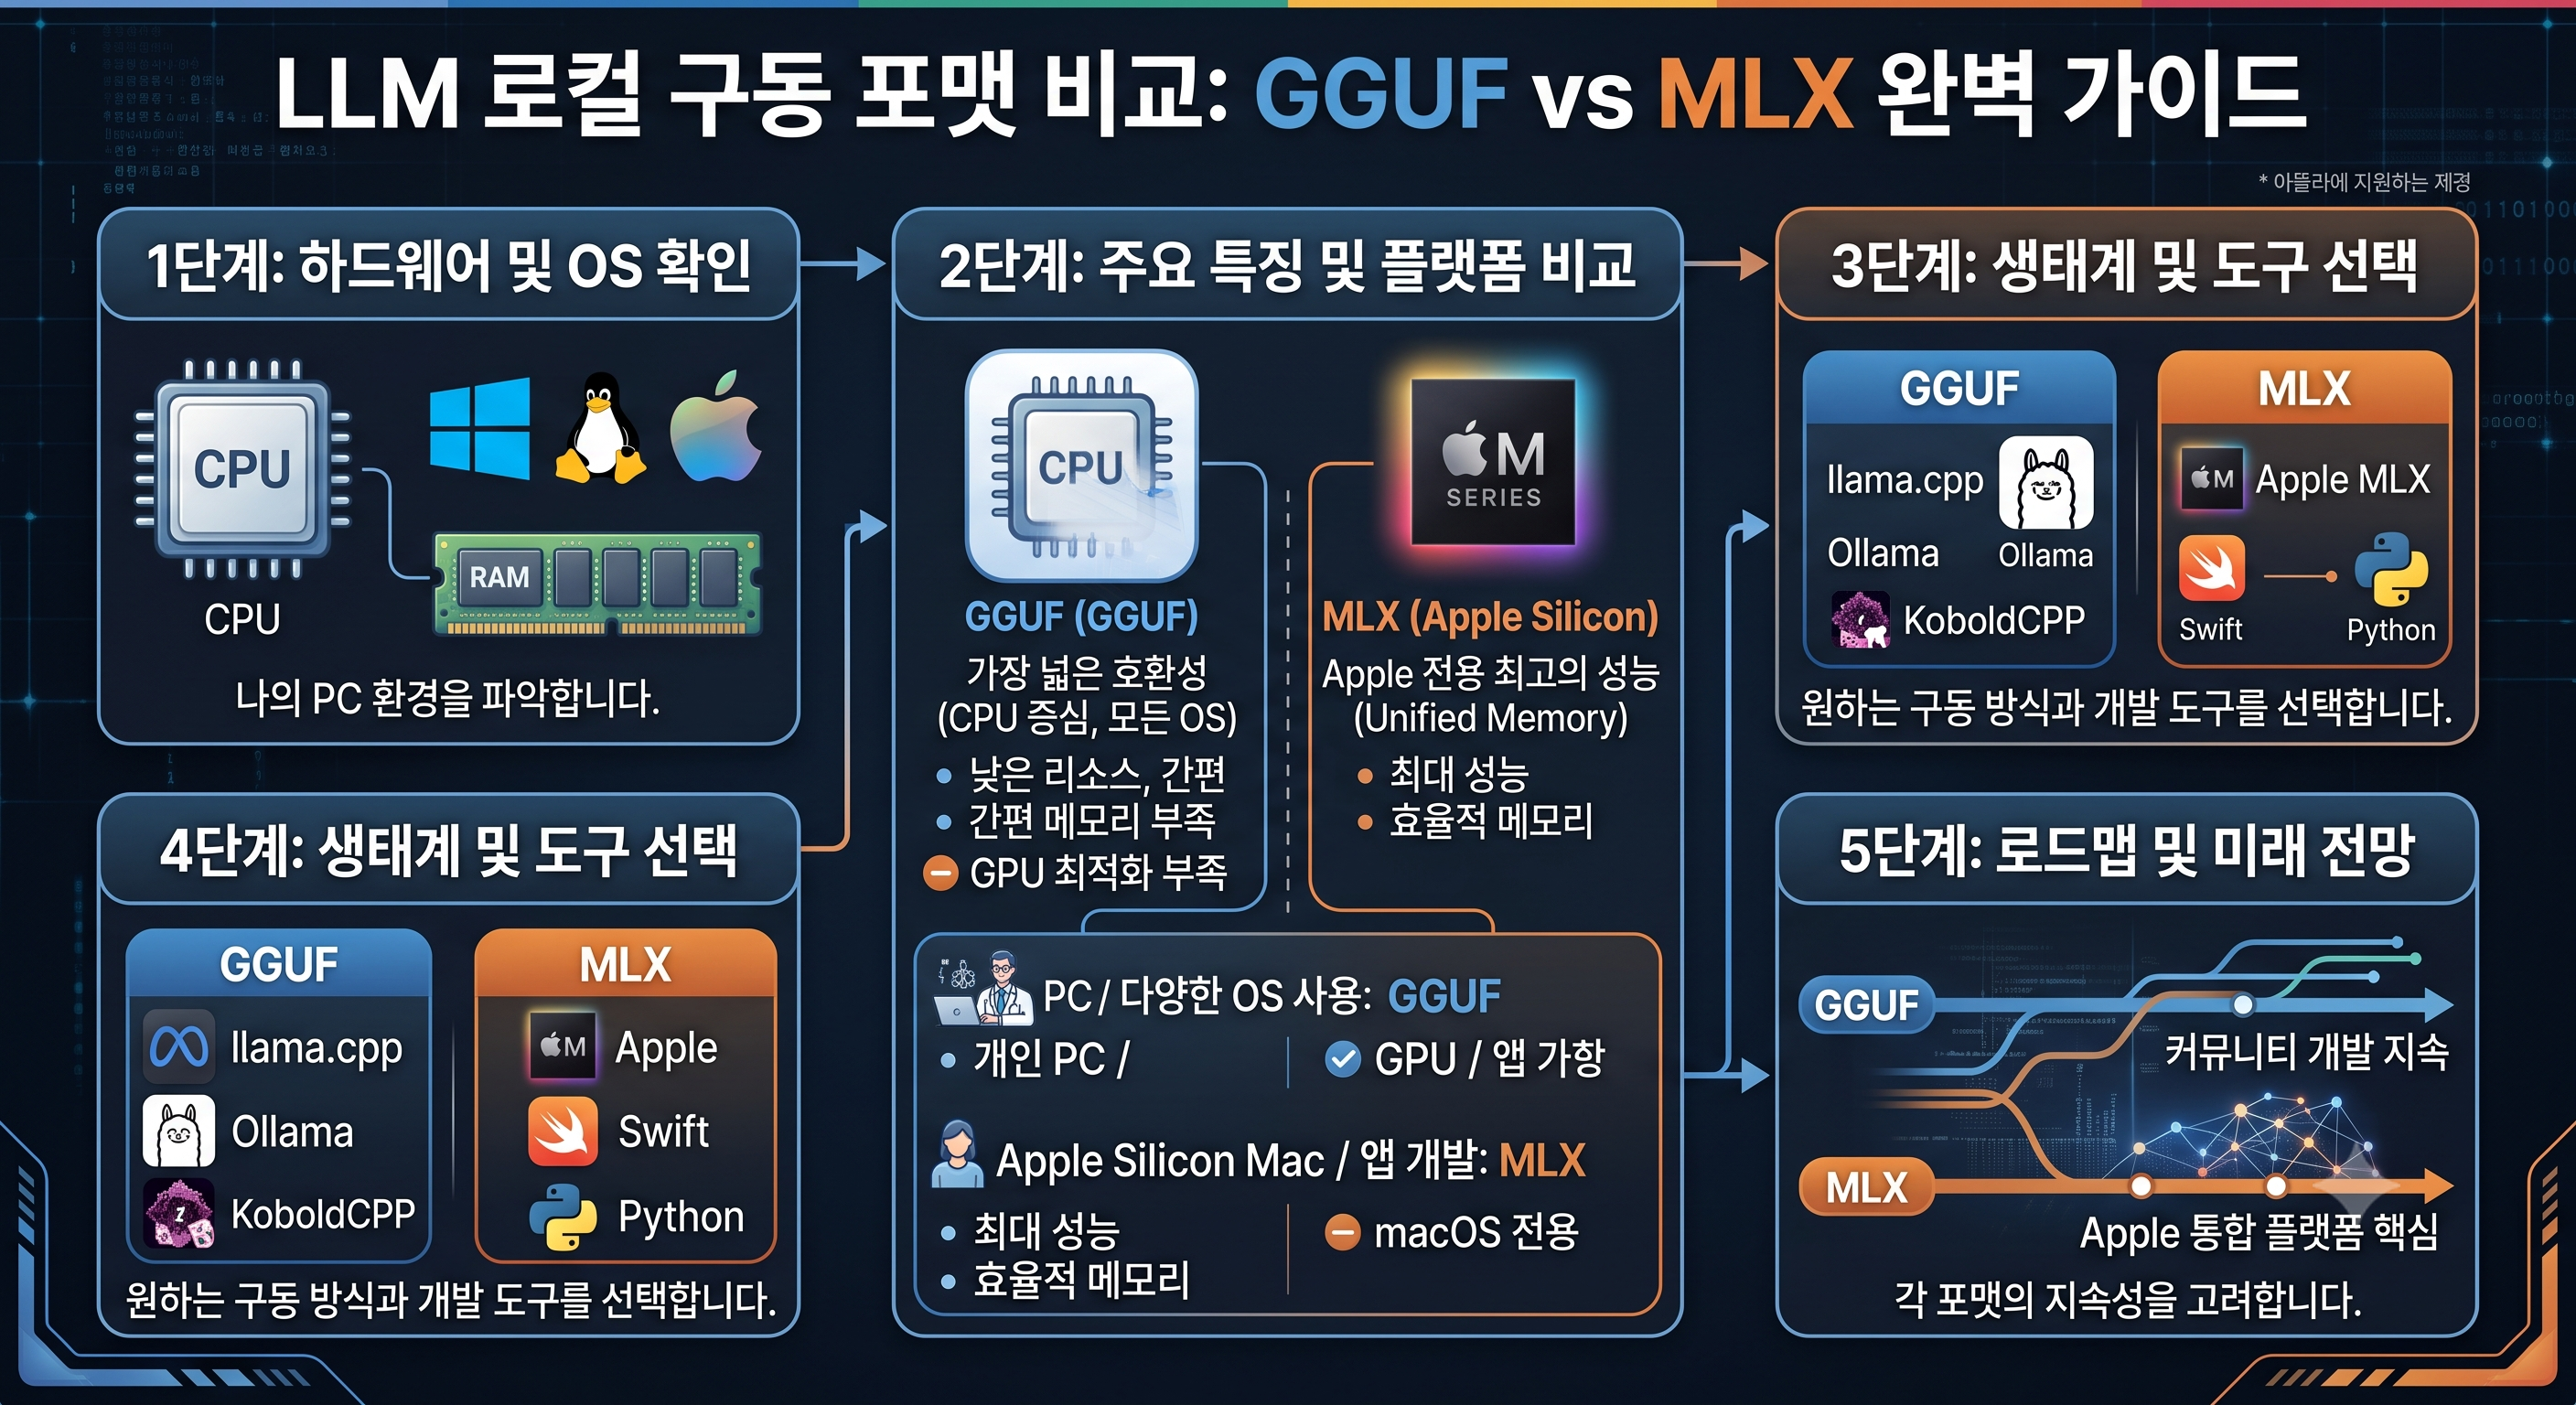
로컬 PC에서 오픈소스 거대언어모델(LLM)을 직접 실행할 때 가장 널리 쓰이는 두 가지 선택지는 GGUF와 MLX입니다. 두 포맷의 기술적 구조와 하드웨어 활용 방식, 그리고 환경별 추천 선택 기준을 정리합니다.
1. 핵심 개념 이해
- GGUF (GPT-Generated Unified Format):
llama.cpp 프로젝트에서 개발한 범용 바이너리 모델 파일 포맷입니다. 모델 가중치, 토크나이저, 하이퍼파라미터가 단일 파일에 패키징되어 배포 및 관리가 용이하며, CPU와 GPU 간 하이브리드 연산과 강력한 양자화(Quantization)를 지원합니다.
- MLX: Apple 머신러닝 연구팀이 오픈소스로 공개한 Apple Silicon(M 시리즈) 전용 프레임워크입니다. Mac의 통합 메모리(Unified Memory) 구조에 최적화되어 CPU와 GPU 간 불필요한 데이터 복사 없이 초고속 추론과 파인튜닝을 지원합니다.
[Diagram] 플랫폼 및 연산 아키텍처 비교
- GGUF: 크로스 플랫폼 (Windows / Linux / macOS) ➔ CPU + GPU 분할 오프로딩 지원 (Ollama, LM Studio)
- MLX: macOS 전용 (Apple Silicon) ➔ 통합 메모리 기반 Zero-copy 연산 지원 (mlx-lm, Python 파이프라인)
GGUF와 MLX의 플랫폼 구조 및 하드웨어 메모리 접근 방식 차이
2. GGUF vs MLX 기술 비교
| 비교 항목 |
GGUF |
MLX |
| 지원 플랫폼 |
Windows, Linux, macOS (크로스 플랫폼) |
macOS 전용 (Apple Silicon 필수) |
| 기반 프로젝트 |
llama.cpp |
Apple MLX 프레임워크 |
| 가속 하드웨어 |
NVIDIA CUDA, AMD ROCm, Apple Metal, CPU |
Apple Silicon 내장 GPU 및 통합 메모리 |
| 메모리 오프로딩 |
VRAM 부족 시 시스템 RAM으로 레이어 분할 할당 가능 |
통합 메모리 전체를 단일 풀(Pool)로 활용 |
| 주요 목적 |
초경량 모델 추론 및 범용 로컬 실행 |
Mac 환경에서의 최고 속도 추론 및 로컬 학습/파인튜닝 |
| 대표 구동 도구 |
Ollama, LM Studio, Jan, llama-cpp-python |
mlx-lm, LM Studio(MLX 런타임), MLX 오픈소스 라이브러리 |
| 사전 양자화 모델 생태계 |
Hugging Face 내 최대 점유율 (가장 방대함) |
빠르게 증가 중이나 Apple Silicon 전용에 집중 |
3. 사용 환경별 추천 선택 기준
GGUF를 추천하는 경우
- Windows 또는 Linux PC 환경: MLX는 구동 자체가 불가능하므로 GGUF(또는 ExLlamaV2/vLLM)가 표준적인 선택입니다.
- 원클릭 실행 도구 선호: Ollama, LM Studio, Jan 등 검증된 툴을 통해 복잡한 코드나 세팅 없이 즉시 실행하고 싶은 경우 적합합니다.
- GPU VRAM 용량이 부족한 PC: 모델 용량이 VRAM을 초과할 때 레이어를 CPU RAM으로 나누어 오프로딩해야 하는 환경에서 최적의 안정성을 제공합니다.
MLX를 추천하는 경우
- Apple Silicon Mac 사용자 (Pro / Max / Ultra 권장): 통합 메모리 대역폭을 100% 활용하여 동일 양자화 기준 GGUF보다 더 빠르고 일관된 토큰 생성 속도를 체감할 수 있습니다.
- Mac 로컬 환경에서 파인튜닝(LoRA 등)을 수행하려는 개발자: 단순 추론뿐만 아니라 파이썬 기반의 모델 학습 및 양자화 파이프라인이 직관적으로 지원됩니다.
- 대규모 모델(70B 이상)을 대용량 Mac(64GB RAM 이상)에서 구동할 때: 메모리 복사 과정(Zero-copy)이 없어 컨텍스트 확장 및 모델 구동 효율이 극대화됩니다.
결론
다양한 운영체제 간의 호환성과 풍부한 사전 양자화 모델 라이브러리가 필요하다면 GGUF가 정답이며, Apple Silicon Mac을 기반으로 최고의 추론 속도와 파인튜닝까지 고려한다면 MLX를 사용하는 것이 가장 효과적입니다.

댓글목록
등록된 댓글이 없습니다.